Hast du dir beim Anschauen eines Videos schon einmal gefragt, wie schnell sich etwas darin bewegt? Ein Auto, das auf der Autobahn beschleunigt, ein Sprinter beim Start, ein Vogel, der durchs Bild fliegt. Ohne kalibrierte Kamera, ohne Objekt bekannter Größe und ohne Referenzmessung klingt es wie aus einem Krimi, aus solchem Material eine Zahl herauszuholen.
Es ist schwieriger, als es aussieht, aber nicht unmöglich. Moderne Computer Vision kann aus gewöhnlichen Videos erstaunlich brauchbare Geschwindigkeitsschätzungen gewinnen, solange man versteht, woher die fehlende Information kommen muss.
Das Problem: Geschwindigkeit ohne Lineal
Geschwindigkeit ist Strecke geteilt durch Zeit. Im Video ist die Zeit der einfache Teil: Bei 30 Bildern pro Sekunde liegen zwei aufeinanderfolgende Bilder 1/30 Sekunde auseinander. Schwierig ist die Strecke. Direkt messen kannst du nur, um wie viele Pixel sich ein Objekt bewegt hat, und Pixel sind keine Meter.
Schlimmer noch: Eine einzelne Kamera kann ein kleines Objekt, das sich nah vor der Linse langsam bewegt, nicht von einem großen Objekt unterscheiden, das weit entfernt schnell unterwegs ist. Beide können auf dem Bildschirm genau dieselbe Bewegung erzeugen. Das nennt man Skalenmehrdeutigkeit, und deshalb braucht „ohne Vorwissen“ immer eine Fußnote: Irgendwo muss ein Stück realer Maßstab in die Rechnung einfließen. Die folgenden Techniken unterscheiden sich vor allem darin, woher dieser Maßstab kommt.
Die klassische Abkürzung ist ein Gegenstand bekannter Größe in der Szene: ein Auto (etwa 4,5 Meter lang), eine Fahrbahnmarkierung, eine Tür. Gibt es so etwas nicht, braucht man schwerere Werkzeuge.
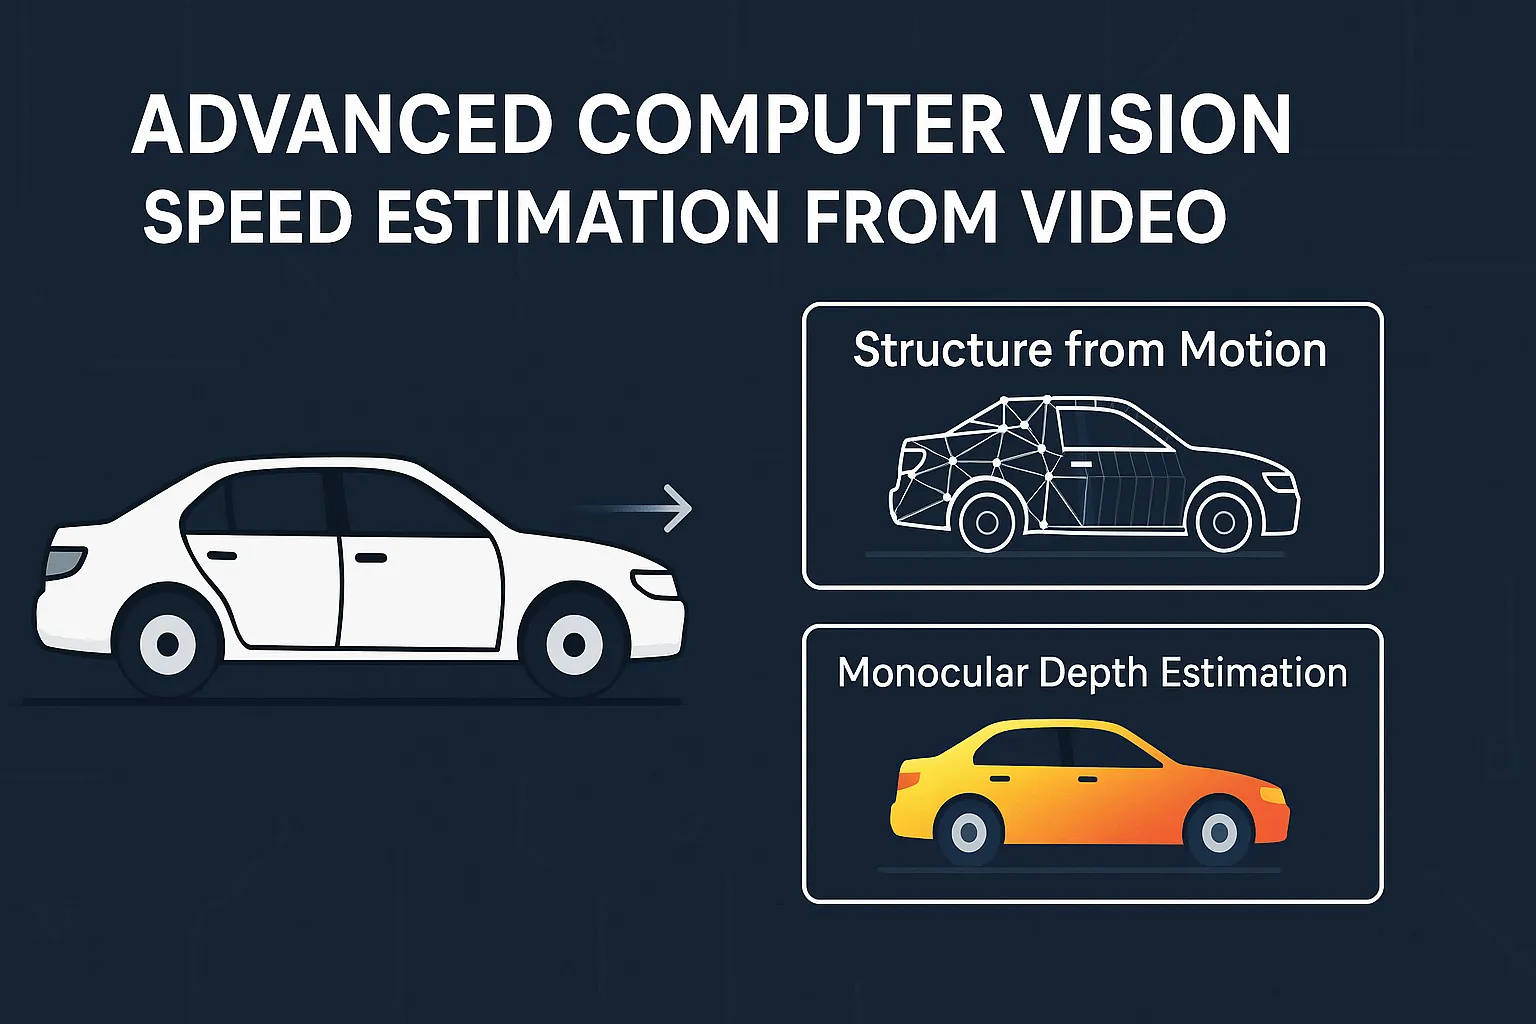
Structure from Motion: von 2D zu 3D
Vielleicht hast du schon 3D-Modelle gesehen, die aus Drohnenaufnahmen entstanden sind. Das ist Structure from Motion (SfM), und es hilft auch beim Schätzen von Geschwindigkeiten.
SfM funktioniert ein wenig wie menschliche Tiefenwahrnehmung: Wer eine Szene aus leicht unterschiedlichen Blickwinkeln betrachtet, bekommt ein Gefühl für Tiefe. SfM analysiert viele Bilder und rekonstruiert sowohl die 3D-Szene als auch den Weg der Kamera durch sie hindurch:
- In jedem Bild werden markante Merkmale wie Ecken und Texturen gefunden, mit Detektoren wie SIFT oder ORB.
- Diese Merkmale werden zwischen den Bildern zugeordnet, und es wird geschätzt, wie sich die Kamera bewegt hat, meist mit dem Fünf-Punkt-Algorithmus innerhalb von RANSAC, damit falsche Zuordnungen aussortiert werden.
- Die zugeordneten Punkte werden per Triangulation in 3D überführt, und alles wird gemeinsam per Bündelblockausgleich (Bundle Adjustment) verfeinert. Dieser Schritt minimiert den Abstand zwischen der Stelle, an der jeder Punkt in jedem Bild erscheinen müsste, und der Stelle, an der er tatsächlich erscheint.
- Dann wird gemessen, wie weit sich das verfolgte Objekt in diesem rekonstruierten Raum bewegt hat.
Die Stärke von SfM: Man versteht die ganze Szene, nicht nur die Pixel. Die Grenze: Die Rekonstruktion stimmt nur bis auf einen unbekannten Skalierungsfaktor. Die Form ist richtig, aber ob man auf eine Modelleisenbahn oder eine echte Stadt schaut, weiß man nicht. Eine einzige bekannte Strecke, etwa die Montagehöhe der Kamera oder die Breite eines Fahrstreifens, löst das Problem.
Monokulare Tiefenschätzung: der Tiefensinn der KI
Eine neuere Möglichkeit sind neuronale Netze, die Tiefe aus einem einzigen Bild schätzen. Sie wurden mit Millionen von Bildern trainiert und haben dieselben Hinweise gelernt, die auch Menschen nutzen: Perspektive, Texturverläufe, Objekte, die andere teilweise verdecken, und die typische Größe vertrauter Dinge.
Es gibt zwei Sorten, und für die Geschwindigkeit ist der Unterschied entscheidend:
- Relative Tiefenmodelle wie MiDaS oder das ursprüngliche Depth Anything sagen dir, welche Flächen näher und welche weiter weg sind, aber nicht, um wie viele Meter. Sie eignen sich, um eine Szene zu ordnen, nicht um sie zu vermessen.
- Metrische Tiefenmodelle wie ZoeDepth, Metric3D oder die metrischen Varianten von Depth Anything V2 versuchen, direkt echte Entfernungen auszugeben, und nutzen ihr gelerntes Wissen über die Welt als Maßstab. Ihre Schätzungen sind Näherungen und in Szenen zuverlässiger, die ihren Trainingsdaten ähneln, etwa Straßen und Innenräume.
Für eine Geschwindigkeitsschätzung lässt du auf jedem Bild ein metrisches Tiefenmodell laufen, verfolgst das Objekt, rechnest seine Bildposition samt Tiefe in eine 3D-Position um und teilst die zurückgelegte Strecke durch die vergangene Zeit. Mittle über viele Bilder, denn einzelne Tiefenschätzungen schwanken.
Eine praktische Pipeline
- Erkennen und verfolgen. Ein Detektor aus der YOLO-Familie zusammen mit einem Tracker wie ByteTrack oder DeepSORT hält die Identität jedes Objekts von Bild zu Bild fest.
- Kamerabewegung herausrechnen. Bewegt sich die Kamera, schätzt man die Bewegung des Hintergrunds per optischem Fluss (Farnebäck oder ein gelerntes Modell wie RAFT) und zieht sie ab, damit nur die Eigenbewegung des Objekts gemessen wird.
- Maßstab einbringen. Nutze, was verfügbar ist: eine bekannte Objektgröße, die Höhe der Kamera über der Straße, Fluchtpunktgeometrie oder ein metrisches Tiefenmodell.
- Ergebnis glätten. Geschwindigkeiten aus einzelnen Bildpaaren sind verrauscht. Passe eine glatte Bahn an oder mittle über ein Zeitfenster.
Welcher Ansatz wann?
| Technik | Funktioniert am besten, wenn | Typisches Versagen |
|---|---|---|
| Structure from Motion | die Kamera sich bewegt und die Szene viel Textur hat | Reine Drehung, kaum Parallaxe, strukturlose Flächen |
| Monokulare Tiefe | die Kamera steht oder das Material unscharf bzw. niedrig aufgelöst ist | Der Maßstab driftet von Bild zu Bild; langsam auf einfacher Hardware |
| Optischer Fluss und Tracking | Geschwindigkeiten in Echtzeit gebraucht werden | Bewegungsunschärfe und das Aperturproblem an texturlosen Kanten |
In der Praxis liefert die Kombination die besten Ergebnisse: SfM oder bekannte Geometrie für den Gesamtmaßstab, ein Tiefenmodell für die Lücken, in denen die Geometrie versagt, und Tracking mit optischem Fluss für die Bewegung von Bild zu Bild.
Der Einstieg
- Für SfM: COLMAP ist ein ausgereiftes Open-Source-Paket.
- Für Tiefe: MiDaS und Depth Anything lassen sich leicht mit PyTorch nutzen; wer Meter braucht, nimmt eine metrische Variante.
- Für Tracking: ein YOLO-Detektor mit ByteTrack oder DeepSORT.
Teste immer mit einem Video von etwas, dessen Geschwindigkeit du kennst, zum Beispiel einem Auto, das zusammen mit seinem Tacho gefilmt wurde. Nur so findest du heraus, wie weit deine Pipeline danebenliegt.
Wo das eingesetzt wird
- Verkehrsüberwachung ohne teure Radartechnik
- Sportanalyse und Leistungsmessung
- Wildtierforschung, bei der Tiere ungestört gefilmt werden können
- Entwicklung und Tests autonomer Fahrzeuge
- Forensische Auswertung von Videobeweisen
Zum Schluss
Geschwindigkeit aus unkalibrierten Videos zu schätzen, ist keine Science-Fiction mehr, aber auch keine Zauberei. Jedes Verfahren muss seinen Sinn für den realen Maßstab irgendwoher beziehen: aus Geometrie, aus einem vertrauten Gegenstand oder aus der gelernten Vorstellung eines neuronalen Netzes davon, wie groß Dinge normalerweise sind. Wer weiß, woher sein Maßstab kommt, weiß auch, wie sehr er der Zahl trauen kann.
Wofür würdest du das einsetzen? Schreib es in die Kommentare.