Vielleicht schauen wir in ein paar Jahren auf diese Zeit zurück und sagen: Da hat alles angefangen. Mit On-Device-Modellen können große Firmen genauso wie Einzelentwickler Produkte bauen, ohne die Datenschutzsorgen, die entstehen, sobald Nutzerdaten auf einen Server wandern.
Ich sage gleich vorweg: Ganz so weit sind wir meiner Meinung nach noch nicht. Aber ich glaube nicht, dass man falsch liegt, wenn man in den nächsten Jahren eine Welle von Apps für ganz bestimmte Aufgaben erwartet. Was Kosten und dezentrale KI angeht, erleben wir gerade wichtige Tage.
Je seltener sich On-Device-Modelle etwas ausdenken, desto eher könnte sich KI nicht mehr wie ein „Dienst“ anfühlen, sondern wie gewöhnliche „Software“, die einfach auf deinem Rechner installiert ist. Dieser Gedanke ist mir in den letzten Wochen klarer geworden, während ich mit den neuen kleinen offenen Modellen herumprobiert und die Übersichtsarbeit von Wang und Kollegen zu On-Device-KI gelesen habe. Dieser Beitrag liegt irgendwo dazwischen: ein bisschen Literatur, ein bisschen Notizen aus der Praxis.
Was genau ist On-Device-KI?
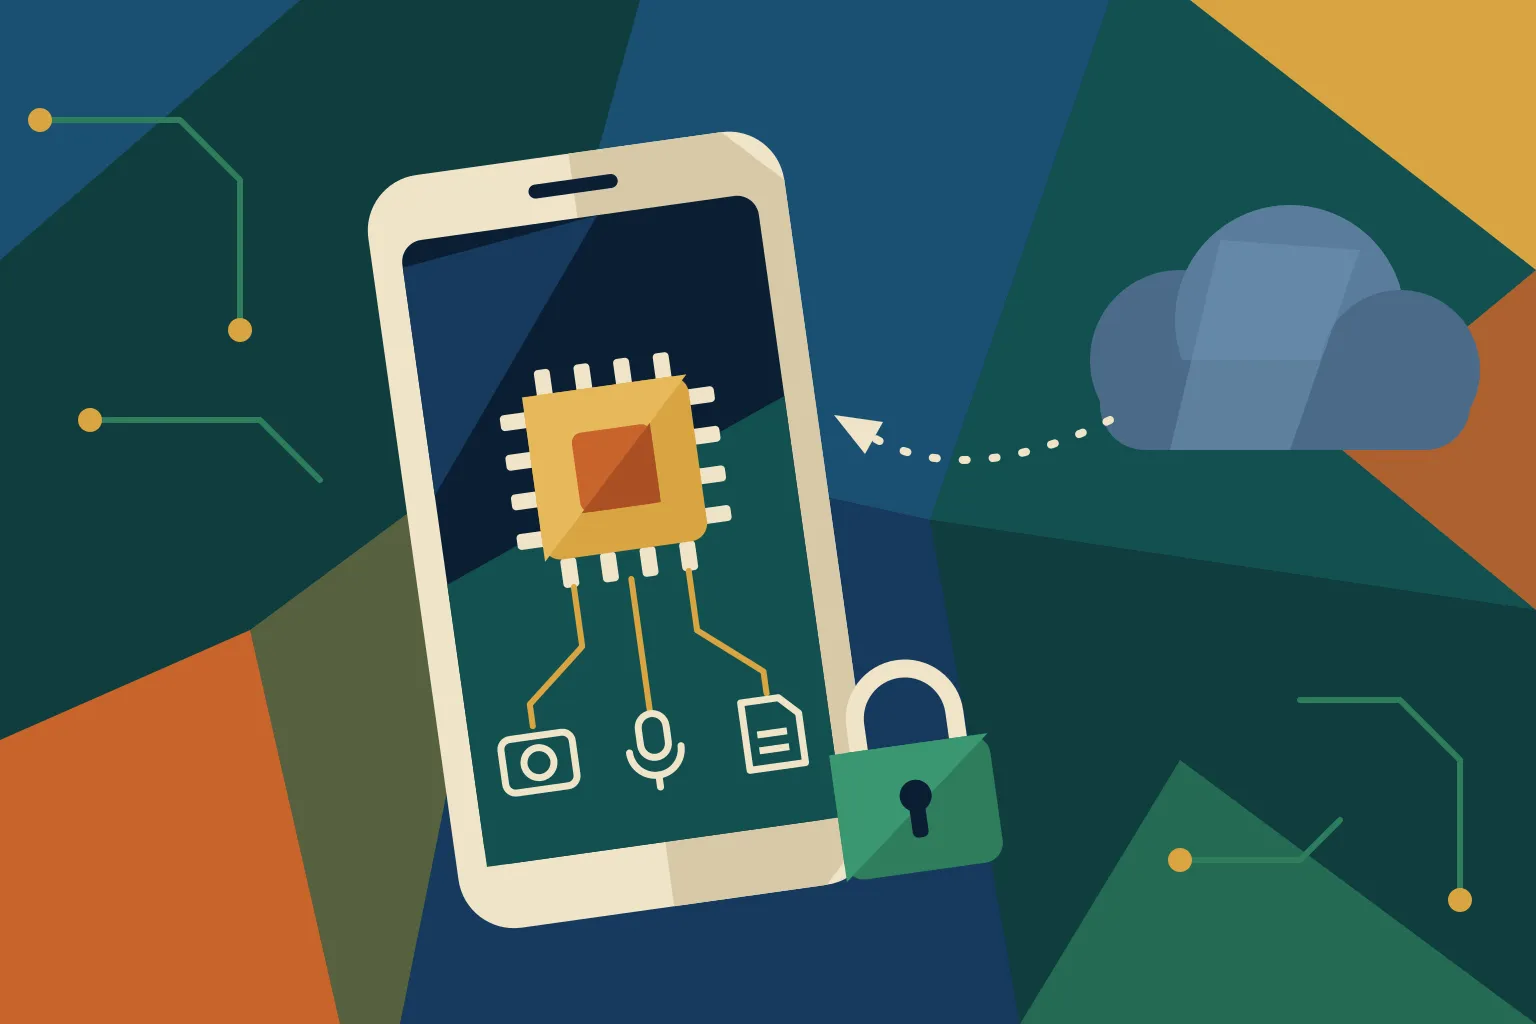
Ganz einfach gesagt bedeutet On-Device-KI, dass das Modell die Inferenz direkt auf dem Gerät ausführt, statt die Daten in die Cloud zu schicken. Ob das Gerät ein Smartphone, eine Uhr, ein Auto, ein Sensor in der Fabrikhalle oder ein Laptop ist, spielt keine Rolle. Die Literatur nennt drei Gemeinsamkeiten dieser Modelle: Sie antworten in Echtzeit, sie müssen mit begrenzter Rechenleistung, wenig Speicher und wenig Energie auskommen, und weil die Daten lokal bleiben, stärken sie den Datenschutz.
Warum das Thema gerade jetzt so wichtig wird, fasst eine Gartner-Prognose von vor einigen Jahren gut zusammen: Bis 2025 sollten rund 75 % der Daten, die Unternehmen erzeugen, außerhalb klassischer Rechenzentren entstehen. Wenn Daten ohnehin am Rand des Netzes (Edge) entstehen, ergibt es wegen Latenz, Bandbreite und Kosten immer weniger Sinn, alles in die Zentrale zu schaffen und dort zu verarbeiten.
Auf der anderen Seite steht die Modellgröße. GPT-3 mit 175 Milliarden Parametern brauchte rund 800 GB Speicher, und so ein Modell auf ein Smartphone zu bringen, war undenkbar. Heute gibt es Sprachmodelle, die von Anfang an für Geräte entworfen wurden, etwa Gemma 2B und Llama 3.2 1B, und sogar multimodale Modelle mit weniger als einer Milliarde Parametern. Der Abstand ist viel schneller geschrumpft, als ich erwartet hätte.
Cloud oder Gerät? Es kommt auf den Trade-off an
Auf dem Gerät zu rechnen ist nicht umsonst: Was du bei Latenz und Datenschutz gewinnst, zahlst du bei Skalierung und Wartung zurück.
| Aspekt | Auf dem Gerät (on-device) | In der Cloud |
|---|---|---|
| Rechenleistung | Durch die Hardware des Geräts begrenzt, Optimierung ist Pflicht | Trägt große, komplexe Modelle problemlos |
| Latenz | Niedrig, kein Umweg übers Netz | Hängt vom Netz ab, riskant bei zeitkritischen Aufgaben |
| Datenschutz | Daten verlassen das Gerät nicht | Daten gehen an einen Server, die Angriffsfläche wächst |
| Skalierung | Die Hardware ist, was sie ist | Ressourcen wachsen mit dem Bedarf |
| Updates und Wartung | Verteilung auf Tausende Geräte ist mühsam | Zentral verwaltet |
| Kostenmodell | Die Inferenzkosten trägt das Gerät des Nutzers | Bezahlung pro Anfrage oder pro Token |
| Offline-Betrieb | Ja | Nein |
In der Praxis sehe ich, dass diese Tabelle keine Entweder-oder-Entscheidung ist. Die gesündesten Architekturen sind hybrid: Was latenz- oder datenschutzkritisch ist, bleibt auf dem Gerät, und was wirklich rechenintensiv ist, geht in die Cloud. Die Literatur nennt das Cloud-Edge-Kollaboration oder Offloading; in der Praxis fängt es oft mit einem kleinen Router-Modell auf dem Gerät an.
Drei Ebenen, um ein Modell aufs Gerät zu bringen: Daten, Modell, System
Die für mich nützlichste Idee der Übersichtsarbeit ist, die Optimierung nicht auf einen einzigen Trick zu stützen, sondern auf drei Ebenen zu verteilen: die Daten, das Modell und das System, das es ausführt. Vernachlässigst du eine davon, bleibt das, was du auf den anderen beiden gewonnen hast, oft auf der Strecke.
- Rauschen filtern
- Dimensionsreduktion
- Sensorfusion
- 32 → 8 Bit Genauigkeit
- Quantisierung
- Pruning
- Wissensdestillation
- Low-Rank, NAS
- Inferenz-Frameworks
- NPU, GPU, CPU
- Scheduling
- Speicherverwaltung
Daten: die Arbeit verringern, bevor sie anfällt
„Garbage in, garbage out“ gilt auf dem Gerät noch härter, weil jedes überflüssige Datum Rechenzeit und Akku kostet. Verrauschte Messungen aussortieren, per Dimensionsreduktion nur aussagekräftige Merkmale behalten, die Daten mehrerer Sensoren zusammenführen und die Genauigkeit von 32 auf 8 Bit senken: Das sind die wichtigsten Werkzeuge dieser Ebene. Jedes hat seinen Preis. Wer zu aggressiv filtert, wirft mit dem Rauschen auch wertvolles Signal weg.
Modell: dieselbe Arbeit mit weniger Parametern
Über diese Ebene wird am meisten gesprochen:
- Quantisierung: Gewichte von 32-Bit-Gleitkommazahlen auf 8-Bit-Ganzzahlen oder noch weiter reduzieren. Das spart viel Speicher und bringt Tempo; übertreibst du es, sinkt die Genauigkeit, und nicht jede Hardware unterstützt jedes Format.
- Pruning: Unwichtige Gewichte oder Neuronen entfernen. Verfahren wie DropNet berichten, die Komplexität eines Netzes um bis zu 90 % zu senken, ohne Genauigkeit einzubüßen, aber starkes Pruning erfordert meist ein erneutes Training.
- Wissensdestillation (Knowledge Distillation): Ein kleines „Schüler“-Modell lernt von den Ausgaben eines großen „Lehrer“-Modells. Auch die kleinen Versionen von Gemma 2 und Llama 3.2 wurden auf diese Weise trainiert.
- Low-Rank-Zerlegung und Parameter-Sharing: Gewichtsmatrizen durch kleinere Matrizen annähern oder dieselben Gewichte in mehreren Schichten verwenden.
- Hardwarebewusste Architektursuche (NAS): Die Architektur direkt am Latenz- und Energiebudget des Zielgeräts ausrichten.
Am besten wirken diese Techniken zusammen. Das klassische Beispiel ist Deep Compression: Pruning, Quantisierung und Huffman-Kodierung in einer Pipeline, die das Netz deutlich verkleinert.
Auch das Architekturdesign selbst macht viel aus, und die MobileNet-Reihe zeigt das schön. V1 erreicht auf ImageNet 70,6 % Genauigkeit mit 569 Millionen Multiply-Accumulate-Operationen (MACs), V2 kommt mit 300 Millionen auf 72 %, V3 mit etwa 219 Millionen auf 75,2 %. Die Kosten der Architektursuche haben einen ähnlichen Weg genommen: NASNet-A verbrauchte 48.000 GPU-Stunden, das hardwarebewusste ProxylessNAS erreicht eine etwas höhere Genauigkeit (74,6 %) in rund 200 GPU-Stunden.
Am spannendsten finde ich zurzeit den Ansatz „ein Modell, viele Budgets“. Once-for-All (OFA) trainiert ein Netz einmal und leitet daraus Teilnetze für verschiedene Geräte ab; DynaBERT passt Breite und Tiefe von BERT an die Ressourcen des Geräts an. Dieselbe Idee sehen wir heute bei Embedding-Modellen in Form von Matryoshka Representation Learning (MRL).
Ein gutes Beispiel ist Googles Anfang Oktober veröffentlichtes EmbeddingGemma 2: Du kannst seine 768-dimensionalen Vektoren bis auf 128 Dimensionen kürzen und die Bild- und Audio-Encoder je nach Bedarf hinzunehmen oder weglassen. Grob überschlagen belegt ein float32-Index für eine Galerie mit 50.000 Fotos bei 768 Dimensionen etwa 154 MB, bei 128 Dimensionen 26 MB. Ein einziges Modell auszuliefern, das jedes Gerät auf sein eigenes Budget zuschneidet, ist für mich die pragmatischste Antwort auf die Vielfalt der Geräte.
System: Software und Hardware zusammen denken
Auf der Softwareseite schlagen Inferenz-Frameworks die Brücke zwischen Modell und Hardware. TensorFlow Lite (heute LiteRT) und PyTorch Mobile, das zunehmend von ExecuTorch abgelöst wird, konvertieren und optimieren Modelle für Mobilgeräte; ONNX Runtime, OpenVINO, TensorRT, NCNN, MNN und Apache TVM konzentrieren sich auf schnelle Inferenz auf unterschiedlicher Hardware. Mit den Sprachmodellen sind llama.cpp, MLX und Ollama dazugekommen.
Bei der Hardware verteilen sich die Optionen auf CPU, GPU, NPU, FPGA und ASIC. Die CPU ist überall vorhanden, aber für KI-Aufgaben ineffizient; die GPU ist stark bei paralleler Arbeit, aber stromhungrig; das FPGA ist flexibel, aber aufwendig in der Entwicklung; ASICs und NPUs bieten für bestimmte Aufgaben unschlagbare Effizienz und verzichten dafür auf Flexibilität. Dass inzwischen fast jedes Smartphone oberhalb der Mittelklasse eine NPU hat, ist die Entwicklung, die das Gleichgewicht in der Praxis wirklich verschoben hat.
Wo On-Device-KI wirklich einen Unterschied macht
Wenn ich mir die Anwendungsfelder ansehe, läuft es immer auf eines von drei Dingen hinaus: Aufgaben, bei denen Millisekunden zählen, Daten, die das Gerät nicht verlassen sollen, und Umgebungen, in denen man sich auf die Verbindung nicht verlassen kann.
| Bereich | Typische Aufgabe | Warum auf dem Gerät? |
|---|---|---|
| Autonomes Fahren | Objekterkennung, Spur- und Tempoentscheidungen | Keine Zeit, auf den Weg in die Cloud und zurück zu warten |
| Gesundheits-Wearables | Puls, Herzrhythmus und Blutdruck überwachen | Gesundheitsdaten sind sensibel, der Akku ist knapp |
| Industrielles IoT | Vorausschauende Wartung, Linienüberwachung | Bandbreite ist teuer, die Linie darf nicht stehen |
| Smart Home | Thermostat, Kamera, Automatisierung | Bild und Ton aus der Wohnung sollen die Wohnung nicht verlassen |
| Smart Farming | Bewässerung und Düngung optimieren | Schwache Verbindung auf dem Feld |
| Smartphone | Sprachassistent, Fotobearbeitung, persönliche Suche | Sofortige Antwort, persönliche Daten |
Dazu kommt ein rechtlicher Vorteil: Wenn die Daten das Gerät nie verlassen, vereinfacht sich ein großer Teil der Fragen rund um die DSGVO schon in der Entwurfsphase.
Die interessanteste Ergänzung dieser Liste im letzten Jahr ist für mich die multimodale Suche. Kleine Embedding-Modelle, die Text, Bilder, Audio und Video in denselben Vektorraum legen, machen es möglich, alles von der Fotogalerie bis zur Besprechungsaufnahme auf dem Gerät zu indexieren und zu durchsuchen. Kommt ein kleines Sprachmodell dazu, entsteht eine RAG-Pipeline (Retrieval-Augmented Generation), die komplett lokal läuft:
- Fotos, Dokumente, Audio, Video
- Embedding-Modell
- Lokaler Vektorindex
- Frage des Nutzers
- Dasselbe Embedding-Modell
- Ähnlichkeitssuche im Index
- Kleines Sprachmodell gefundene Inhalte + Frage
- Antwort
Auf dem Papier leicht, in der Praxis schwer
In Benchmark-Tabellen sieht alles gut aus; die eigentlichen Probleme beginnen, wenn das Modell auf echte Geräte und zu echten Nutzern kommt.
Gerätevielfalt. Gleiches Modell, gleiches Framework, anderes Smartphone: In einer Messung, die die Übersichtsarbeit zitiert, braucht ResNet50 mit PyTorch Mobile auf einem Galaxy S10e 333 ms, auf einem Oppo R17 1.260 ms. Das ist ungefähr der Faktor vier. Die Zahl, die du auf einem Flaggschiff misst, sagt wenig darüber, was deine Nutzer im Schnitt erleben.
Energie und Wärme. Der Akku ist die am meisten unterschätzte Grenze von On-Device-KI. Ein Modell, das im Hintergrund Tausende Dateien verarbeitet, leert den Akku und heizt das Gerät auf, bis es seine Leistung drosselt (Thermal Throttling). Einfache Entscheidungen beim Scheduling, etwa die Arbeit nur zu erledigen, während das Gerät lädt und nicht benutzt wird, bringen oft mehr als das Modell selbst.
Updates und Wartung. In der Cloud tauschst du das Modell einmal aus; auf Geräten leben Dutzende Versionen weiter. Bei Embedding-basierten Systemen wird es noch schwieriger: Vektoren verschiedener Modelle sind nicht miteinander kompatibel, also muss der gesamte Index des Nutzers neu aufgebaut werden, sobald sich das Modell ändert.
Der Preis bei der Genauigkeit. Jede Komprimierungstechnik gibt etwas auf. Selbst wenn die durchschnittliche Genauigkeit gleich bleibt, musst du hinschauen, bei welchen Beispielen du verlierst. Bei Sprachen, die in Trainingsdaten weniger vertreten sind, Türkisch zum Beispiel, kommst du um Tests mit deinen eigenen Daten nicht herum, wenn du keine Überraschungen erleben willst.
Sicherheit. Dass die Daten auf dem Gerät bleiben, ist gut für den Datenschutz, aber für sich genommen keine Garantie: Das Gerät kann gestohlen werden, Schadsoftware kann sich einnisten, und die Gewichte eines in die App eingebetteten Modells lassen sich extrahieren. In der Literatur gelten vertrauenswürdige Ausführungsumgebungen (TEE), homomorphe Verschlüsselung und föderiertes Lernen (Federated Learning) als die wichtigsten Ansätze, um diese Lücken zu schließen.
Kleine Modelle erfinden immer noch Dinge. Auf der generativen Seite halluzinieren kleine Sprachmodelle leichter als ihre großen Verwandten. Eine gute Retrieval-Schicht senkt dieses Risiko, beseitigt es aber nicht. Genau das meinte ich am Anfang, als ich davon sprach, dass sich die Modelle seltener etwas ausdenken.
Die nächsten Jahre: Trends, die ich beobachte
Am meisten erwarte ich davon, dass Foundation-Modelle kleiner werden. Die Idee, ein großes Modell mit breiten Daten vorzutrainieren und es dann per Fine-Tuning an eine bestimmte Aufgabe anzupassen, kommt jetzt auf Geräteebene an. Das ist auch der Grund, warum ich eine Welle von Apps für ganz bestimmte Aufgaben erwarte: Das große Modell trägt das allgemeine Wissen, das kleine Modell auf dem Gerät muss nur seine eigene Aufgabe gut erledigen.
Auch hybride Architekturen werden reifer. 5G und was danach kommt, machen die Arbeitsteilung zwischen Gerät und Cloud flexibler. Wenn das Gerät die erste Auswahl trifft und nur das Nötige verschickt, sinken Latenz, Bandbreite und Kosten gleichzeitig.
Am schwierigsten ist meiner Meinung nach das Lernen auf dem Gerät. Heute führen die meisten Systeme nur die Inferenz lokal aus, trainiert wird weiterhin in der Cloud. Modelle, die sich direkt auf dem Gerät an die Gewohnheiten des Nutzers anpassen, und föderiertes Lernen sehen nach dem nächsten Schritt aus, aber mit den Grenzen bei Speicher und Energie ist das ein viel härteres Problem als Inferenz.
Außerdem werden zwei Debatten lauter. Die eine dreht sich um Energie: Effiziente Modelle und sparsame Beschleuniger werden nicht mehr nur wegen der Akkulaufzeit diskutiert, sondern auch wegen des Stromverbrauchs von Rechenzentren, und eine Architektur, in der nicht jede Anfrage in ein Rechenzentrum geht, hat dabei die besseren Karten. Die andere dreht sich um Kontrolle. Bias und Erklärbarkeit kleiner Modelle sind zu einem eigenen Forschungsfeld geworden, und ein Modell, das auf dem Gerät des Nutzers läuft, lässt sich schwerer prüfen. Tests und Transparenz müssen deshalb von Anfang an eingeplant werden, nicht erst nachträglich.
Wenn KI vom Dienst zur Software wird
Niemand hält SQLite für einen „Dienst“. Es läuft auf fast jedem Smartphone und in fast jedem Browser, aber niemand besorgt sich dafür einen API-Schlüssel, zahlt eine Rechnung oder fragt sich, wohin seine Daten gehen. Es ist einfach eine gewöhnliche Komponente, die mit der App kommt.
Dass KI-Modelle an denselben Punkt kommen, scheint mir gar nicht so weit weg, und die Forschung schaut in dieselbe Richtung. Die auf der MobiCom 2024 veröffentlichte Arbeit „Mobile Foundation Model as Firmware“ schlägt vor, das Foundation-Modell als fest im Gerät verankerte Infrastrukturschicht zu verstehen, statt als etwas, das jede App einzeln mitbringt. Auch für Entwickler ändert sich die Rechnung: Die Inferenzkosten wandern auf das Gerät des Nutzers, und die Abrechnung pro Token fällt weg.
Für mich ist das die greifbarste Form der Debatte um dezentrale KI: Die Gewichte des Modells sind offen, und die Hardware, auf der es läuft, steckt in der Tasche des Nutzers. Sobald generative Modelle zuverlässig genug sind, wird „meine App hat KI“ so alltäglich klingen wie heute „meine App hat eine Datenbank“. Bis dahin rate ich dir, dir ein kleines, konkretes Problem zu suchen und diese Werkzeuge schon jetzt kennenzulernen.
Häufige Fragen
Was ist On-Device-KI?
Ein KI-Modell führt die Inferenz direkt auf einem Smartphone, Computer, Auto oder IoT-Gerät aus, ohne die Daten in die Cloud zu schicken. Kennzeichnend sind geringe Latenz, die Fähigkeit, mit begrenzten Ressourcen auszukommen, und dass die Daten lokal bleiben.
Ist Edge AI dasselbe wie On-Device-KI?
Ähnlich, aber nicht dasselbe. Edge AI ist der weitere Oberbegriff dafür, die Verarbeitung an einen beliebigen Punkt nahe der Datenquelle zu verlagern (Edge-Server, Gateways, Geräte); On-Device-KI meint den Fall, in dem die Arbeit direkt auf dem Endgerät des Nutzers passiert.
Wie bekommt man ein KI-Modell auf ein Gerät?
Meist durch eine Kombination mehrerer Techniken: Quantisierung, Pruning, Wissensdestillation und effizientes Architekturdesign. Dazu kommen ein passendes Inferenz-Framework und Hardwarebeschleuniger wie eine NPU.
Läuft ein großes Sprachmodell auf dem Smartphone?
Kleine Sprachmodelle schon. Modelle mit 1 bis 3 Milliarden Parametern laufen mit Quantisierung auf aktuellen Smartphones, aber Tempo, Akkuverbrauch und Antwortqualität schwanken je nach Gerät stark.
Garantiert On-Device-KI den Datenschutz?
Für sich allein nicht. Wenn die Daten das Gerät nicht verlassen, sinkt das Risiko, aber die Sicherheit des Geräts, der Schutz des Modells und die Frage, wie die App Daten speichert, müssen trotzdem eigens behandelt werden.
Quellen und weiterführende Literatur
- Wang, X. et al. (2025). Empowering Edge Intelligence: A Comprehensive Survey on On-Device AI Models. ACM Computing Surveys. arXiv:2503.06027
- Luo, C. et al. (2020). Comparison and Benchmarking of AI Models and Frameworks on Mobile Devices. arXiv:2005.05085
- Yuan, J. et al. (2024). Mobile Foundation Model as Firmware. MobiCom 2024.
- Google DeepMind (6. Oktober 2026). Ankündigung von EmbeddingGemma 2 und Model Card.