Bugünler, birkaç yıl sonra dönüp baktığımızda "aslında her şey o zaman başlamıştı" diyeceğimiz bir dönüşümün ilk günleri olabilir. On-device modeller sayesinde hem büyük firmalar hem de tek başına uygulama geliştiren biri, kullanıcı verisini bir sunucuya taşımanın getirdiği privacy kaygısını yaşamadan ürün geliştirebilir hale geliyor.
Tam olarak yeterli noktada olduğumuza henüz inanmıyorum, bunu baştan söyleyeyim. Ama spesifik görevler için özelleştirilmiş uygulamaların önümüzdeki dönemde patlama yapmasını beklemek bence hata olmaz. Hem maliyet hem de merkeziyetsiz AI açısından önemli günlerden geçiyoruz.
On-device modeller daha az saçmaladıkça yapay zeka bir "servis" olmaktan çıkıp bilgisayarımızda kurulu duran sıradan bir "yazılım" gibi algılanmaya başlayabilir. Bu fikir son haftalarda hem yeni çıkan küçük açık modelleri kurcalarken hem de Wang ve arkadaşlarının on-device AI üzerine hazırladığı kapsamlı derlemeyi okurken kafamda iyice netleşti. Bu yazı o ikisinin arasında bir yerde duruyor: biraz literatür, biraz sahadan not.
On-device AI tam olarak ne demek?
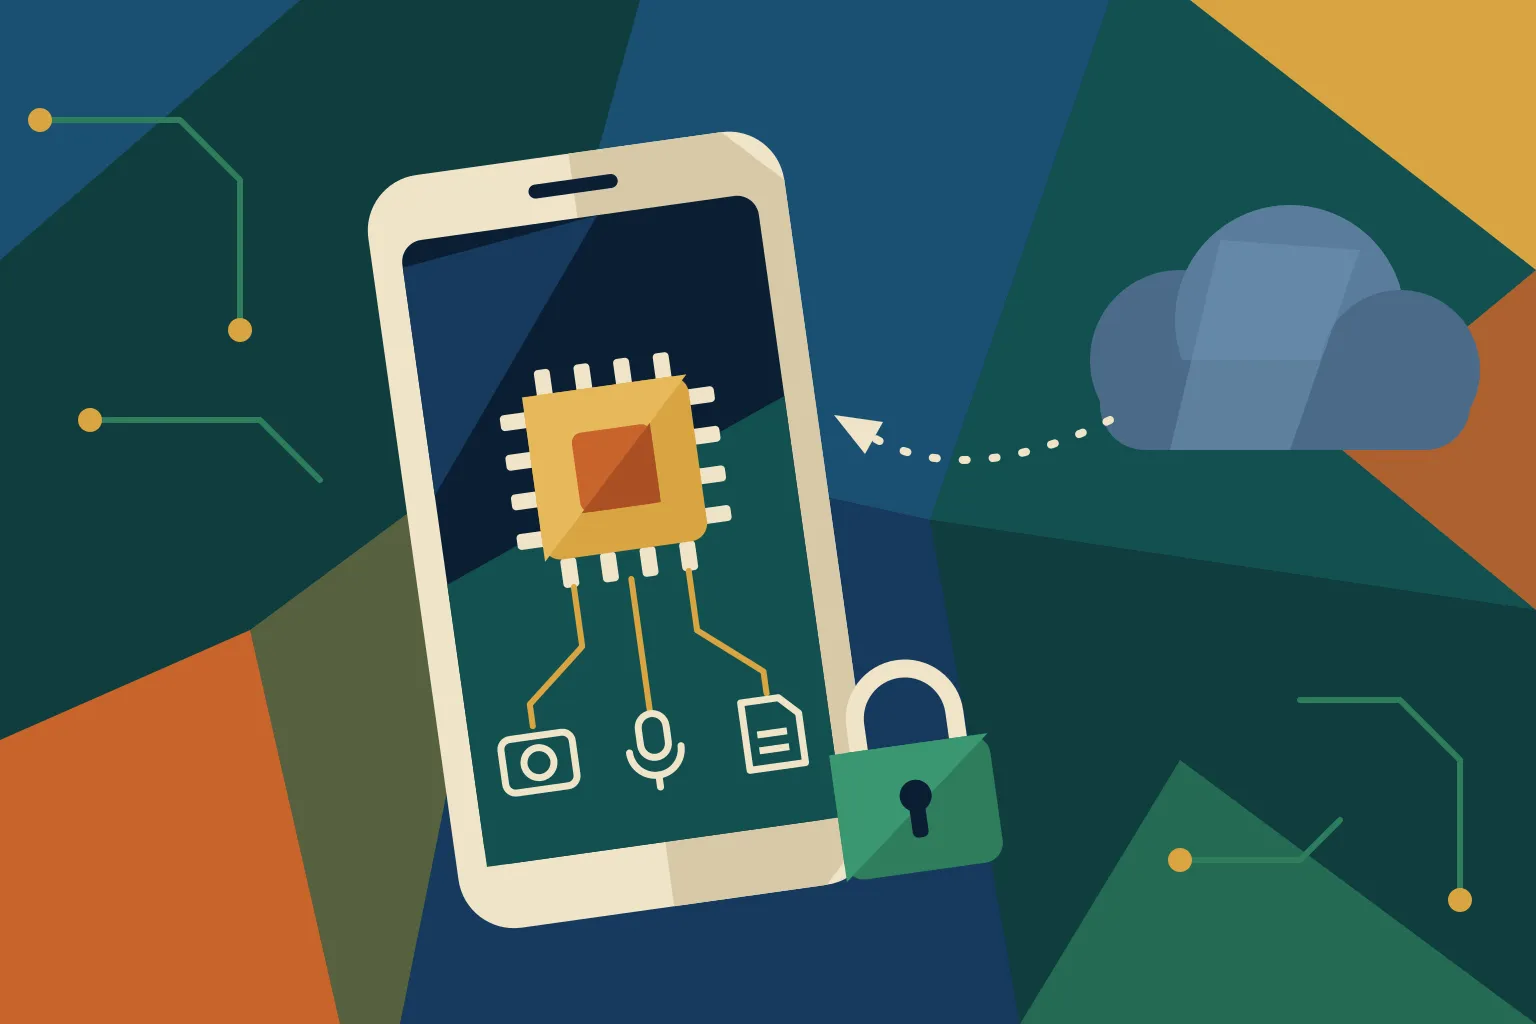
En sade tanımıyla on-device AI, modelin veriyi buluta göndermeden çıkarımı (inference) doğrudan cihaz üzerinde yapması. Telefon, saat, araç, fabrikadaki bir sensör ya da laptop olması fark etmiyor. Literatürde bu modellerin üç ortak özelliği öne çıkıyor: gerçek zamanlı yanıt vermeleri, kısıtlı işlem gücü, bellek ve enerjiyle yetinmek zorunda olmaları ve veriyi yerelde tuttukları için gizliliği güçlendirmeleri.
Konunun neden şimdi bu kadar önem kazandığını Gartner'ın birkaç yıl önceki bir öngörüsü iyi özetliyor: 2025 itibarıyla kurumların ürettiği verinin yaklaşık %75'i geleneksel veri merkezlerinin dışında doğacaktı. Veri zaten kenarda (edge) üretiliyorsa, hepsini merkeze taşıyıp orada işlemek gecikme, bant genişliği ve maliyet açısından giderek anlamsızlaşıyor.
Diğer tarafta model boyutları var. 175 milyar parametreli GPT-3 yaklaşık 800 GB depolama istiyordu ve böyle bir modeli telefona koymak söz konusu bile değildi. Bugün ise Gemma 2B ve Llama 3.2 1B gibi doğrudan cihaz için tasarlanmış dil modelleri, hatta 1 milyar parametrenin altında kalan multimodal modeller var. Aradaki mesafe beklediğimden çok daha hızlı kapandı.
Bulut mu, cihaz mı? Asıl mesele trade-off
Cihaz üzerinde çalışmak bedava değil: gecikmede ve gizlilikte kazandığınızı ölçeklenmede ve bakımda geri ödüyorsunuz.
| Boyut | Cihaz üzerinde (on-device) | Bulut tabanlı |
|---|---|---|
| İşlem gücü | Cihazın donanımıyla sınırlı, optimizasyon şart | Büyük ve karmaşık modelleri rahat taşır |
| Gecikme | Düşük, ağ gidiş-dönüşü yok | Ağa bağlı, zaman kritik işlerde risk |
| Gizlilik | Veri cihazdan çıkmaz | Veri sunucuya gider, saldırı yüzeyi büyür |
| Ölçeklenme | Donanım neyse o | Kaynak ihtiyaca göre büyütülür |
| Güncelleme ve bakım | Binlerce cihaza dağıtım zahmetli | Tek merkezden yönetilir |
| Maliyet modeli | Çıkarım maliyeti kullanıcının cihazında | İstek veya token başına ödeme |
| Çevrimdışı çalışma | Var | Yok |
Sahada gördüğüm, bu tablonun bir "ya o ya bu" seçimi olmadığı. En sağlıklı mimariler hibrit: gecikmeye ve gizliliğe duyarlı işler cihazda kalıyor, gerçekten ağır olanlar buluta gidiyor. Literatür buna bulut-kenar iş birliği ya da offloading diyor; pratikte ise çoğu zaman cihazdaki küçük bir yönlendirici (router) modelle başlıyor.
Modeli cihaza sığdırmanın üç katmanı: veri, model, sistem
Derlemedeki bence en kullanışlı fikir, optimizasyonu tek bir hileye değil üç katmana yaymak: veriye, modele ve onu çalıştıran sisteme. Birini ihmal ettiğinizde diğer ikisinde kazandığınız çoğu zaman masada kalıyor.
- Gürültü ayıklama
- Boyut indirgeme
- Sensör füzyonu
- 32 → 8 bit hassasiyet
- Kuantizasyon
- Budama
- Bilgi damıtma
- Düşük rank, NAS
- Çıkarım çatıları
- NPU, GPU, CPU
- Zamanlama
- Bellek yönetimi
Veri: hesaplanacak işi baştan azaltmak
"Çöp girerse çöp çıkar" kuralı cihazda daha acı biçimde geçerli, çünkü gereksiz her veri hem işlem hem pil demek. Gürültülü ölçümleri ayıklamak, boyut indirgemeyle yalnızca anlamlı öznitelikleri tutmak, birden çok sensörün verisini birleştirmek ve verinin hassasiyetini 32 bitten 8 bite düşürmek bu katmanın temel araçları. Her birinin bir bedeli var; aşırı filtreleme, değerli sinyali de gürültüyle birlikte çöpe atabiliyor.
Model: aynı işi daha az parametreyle yapmak
En çok konuşulan katman burası:
- Kuantizasyon: Ağırlıkları 32 bit kayan noktadan 8 bit tam sayıya ya da daha aşağısına indirmek. Bellekte ve hızda büyük kazanç sağlıyor; agresif yapılırsa doğruluk düşüyor ve her donanım her formatı desteklemiyor.
- Budama (pruning): Önemsiz ağırlıkları ya da nöronları atmak. DropNet gibi yöntemler doğruluğu bozmadan ağ karmaşıklığını %90'a varan oranda azalttığını raporluyor, ama ağır budama çoğu zaman yeniden eğitim istiyor.
- Bilgi damıtma (knowledge distillation): Büyük bir "öğretmen" modelin çıktılarını küçük bir "öğrenci" modele öğretmek. Gemma 2 ve Llama 3.2'nin küçük sürümleri de eğitimlerinde bu yaklaşımdan yararlandı.
- Düşük rank ayrıştırma ve parametre paylaşımı: Ağırlık matrislerini daha küçük matrislerle yaklaşıklamak ya da katmanlar arasında ağırlıkları ortak kullanmak.
- Donanım farkında mimari arama (NAS): Mimariyi doğrudan hedef cihazın gecikme ve enerji bütçesine göre aramak.
Bu teknikler en iyi sonucu birlikte kullanıldığında veriyor. Klasik örnek Deep Compression: budama, kuantizasyon ve Huffman kodlamayı tek bir hatta birleştirip ağ boyutunu ciddi oranda küçültüyor.
Mimari tasarımın kendisi de büyük fark yaratıyor ve MobileNet serisi bunun güzel bir hikâyesi. V1, ImageNet'te %70,6 doğruluğa 569 milyon çarpma-toplama işlemiyle (MAC) ulaşırken V2 %72'ye 300 milyonla, V3 ise %75,2'ye yaklaşık 219 milyonla çıkıyor. Mimari aramanın maliyeti de benzer bir yol izledi: NASNet-A 48 bin GPU saati yakarken, donanım farkında çalışan ProxylessNAS biraz daha yüksek doğruluğa (%74,6) yaklaşık 200 GPU saatinde ulaşıyor.
Son dönemde en çok ilgimi çeken eğilim ise "tek model, birçok bütçe" yaklaşımı. Once-for-All (OFA) bir kez eğitilen ağdan farklı cihazlar için alt ağlar çıkarmayı, DynaBERT ise BERT'in genişliğini ve derinliğini cihazın kaynaklarına göre ayarlamayı öneriyor. Aynı fikri bugün embedding modellerinde Matryoshka Representation Learning (MRL) ile görüyoruz.
Örneğin Google'ın Ekim başında yayınladığı EmbeddingGemma 2, 768 boyutlu vektörünü 128 boyuta kadar kırpmanıza ve görsel ya da ses encoder'larını ihtiyaca göre ekleyip çıkarmanıza izin veriyor. Kaba bir hesapla 50 bin fotoğraflık bir galerinin float32 indeksi 768 boyutta yaklaşık 154 MB, 128 boyutta 26 MB tutuyor. Tek bir model dağıtıp her cihazın kendi bütçesine göre kesmesi, cihaz çeşitliliği sorununa bence en pragmatik cevap.
Sistem: yazılım ve donanımı birlikte düşünmek
Yazılım tarafında model ile donanım arasındaki köprüyü çıkarım çatıları kuruyor. TensorFlow Lite (bugünkü adıyla LiteRT) ve yerini giderek ExecuTorch'a bırakan PyTorch Mobile modeli mobil için dönüştürüp optimize ediyor; ONNX Runtime, OpenVINO, TensorRT, NCNN, MNN ve Apache TVM ise farklı donanımlarda hızlı çıkarıma odaklanıyor. Dil modelleri döneminde bu listeye llama.cpp, MLX ve Ollama da eklendi.
Donanımda seçenekler CPU, GPU, NPU, FPGA ve ASIC arasında dağılıyor. CPU her yerde var ama yapay zeka işlerinde verimsiz, GPU paralel işte güçlü ama enerjiye aç, FPGA esnek ama geliştirmesi zahmetli; ASIC ve NPU ise belirli işlerde rakipsiz verim sunup esneklikten feragat ediyor. Orta segmentin üstündeki telefonların neredeyse hepsinde artık bir NPU bulunması, sahadaki dengeyi değiştiren asıl gelişme.
On-device AI nerede gerçekten fark yaratıyor?
Uygulama alanlarına baktığımda ortak payda hep aynı üç şeyden biri çıkıyor: milisaniyelerin önemli olduğu işler, verinin dışarı çıkmaması gereken işler ve bağlantının güvenilmez olduğu ortamlar.
| Alan | Tipik görev | Neden cihazda? |
|---|---|---|
| Otonom sürüş | Nesne algılama, şerit ve hız kararları | Buluta gidip gelmeyi bekleyecek zaman yok |
| Giyilebilir sağlık | Nabız, ritim ve tansiyon takibi | Sağlık verisi hassas, pil kısıtlı |
| Endüstriyel IoT | Kestirimci bakım, hat izleme | Bant genişliği pahalı, hat durmamalı |
| Akıllı ev | Termostat, kamera, otomasyon | Ev içi görüntü ve ses dışarı çıkmamalı |
| Akıllı tarım | Sulama ve gübreleme optimizasyonu | Tarlada bağlantı zayıf |
| Akıllı telefon | Sesli asistan, fotoğraf işleme, kişisel arama | Anlık yanıt, kişisel veri |
Türkiye'den bakınca bir avantaj daha var: veri cihazdan çıkmadığında KVKK ve GDPR tarafındaki soruların önemli bir kısmı daha tasarım aşamasında sadeleşiyor.
Bu listeye son bir yılda eklenen en ilginç başlık bence çok modlu (multimodal) arama. Metin, görsel, ses ve videoyu aynı vektör uzayına koyan küçük embedding modelleri sayesinde galeriden toplantı kayıtlarına kadar her şeyi cihazda indeksleyip sorgulamak mümkün hale geldi. Yanına küçük bir dil modeli eklendiğinde ortaya tamamen yerel çalışan bir RAG (retrieval augmented generation) hattı çıkıyor:
- Fotoğraf, belge, ses, video
- Embedding modeli
- Yerel vektör indeksi
- Kullanıcının sorusu
- Aynı embedding modeli
- İndekste benzerlik araması
- Küçük dil modeli bulunan içerik + soru
- Yanıt
Kâğıt üstünde kolay, sahada zor
Benchmark tablolarında her şey yolunda görünür; asıl sorunlar model gerçek cihazlara ve gerçek kullanıcılara dağıtıldığında başlar.
Cihaz çeşitliliği. Aynı model, aynı framework, farklı telefon: derlemede aktarılan bir ölçümde ResNet50, PyTorch Mobile ile Galaxy S10e'de 333 ms sürerken Oppo R17'de 1.260 ms sürüyor. Bu yaklaşık dört kat fark demek. Amiral gemisi bir telefonda ölçtüğünüz rakam, kullanıcılarınızın ortalama deneyimini temsil etmiyor.
Enerji ve ısı. Pil, cihaz üzerindeki yapay zekanın en sessiz ama en acımasız kısıtı. Arka planda binlerce dosyayı işleyen bir model hem şarjı eritir hem de cihazı ısıtıp performansını düşürür (thermal throttling). İşi şarjdayken ve cihaz boştayken yapmak gibi basit zamanlama kararları çoğu zaman modelin kendisinden daha fazla fark yaratıyor.
Güncelleme ve bakım. Bulutta modeli bir kez değiştirirsiniz; cihazda ise onlarca farklı sürüm sahada yaşamaya devam eder. Embedding tabanlı sistemlerde iş daha da zorlaşıyor: farklı modellerin vektörleri birbiriyle uyumlu olmadığı için model değiştiğinde kullanıcının bütün indeksi baştan oluşturulmak zorunda.
Doğruluk bedeli. Sıkıştırma tekniklerinin hepsi bir şeylerden feragat ediyor. Ortalama doğruluk aynı kalsa bile kaybın hangi örneklerde yaşandığına bakmak gerekiyor; Türkçe gibi eğitim verisinde daha az temsil edilen dillerde sürpriz yaşamamak için kendi verinizle test etmek şart.
Güvenlik. Verinin cihazda kalması gizlilik için iyi ama tek başına garanti değil: cihaz çalınabilir, kötü amaçlı yazılım bulaşabilir, uygulamaya gömülü modelin ağırlıkları dışarı çıkarılabilir. Literatürde güvenilir çalışma ortamları (TEE), homomorfik şifreleme ve federe öğrenme (federated learning) bu açıkları kapatmak için öne çıkan yaklaşımlar.
Küçük modeller hâlâ uyduruyor. Üretken tarafta küçük dil modelleri büyük kuzenlerine göre daha kolay halüsinasyon görüyor. İyi bir retrieval katmanı bu riski azaltır ama sıfırlamaz. Girişte "daha az saçmaladıkça" derken kastettiğim tam olarak bu.
Önümüzdeki birkaç yıl: izlediğim eğilimler
Temel modellerin küçülmesi. Büyük bir modeli geniş veriyle önceden eğitip sonra belirli bir göreve ince ayarla (fine-tuning) uyarlama fikri artık cihaz ölçeğine iniyor. Spesifik görevler için özelleştirilmiş uygulamaların patlama yapacağını düşünmemin sebebi de bu: genel bilgiyi büyük model taşıyor, cihazdaki küçük model yalnızca kendi işini iyi yapıyor.
Hibrit mimariler ve hızlı ağlar. 5G ve sonrası, cihaz ile bulut arasındaki iş bölümünü daha esnek hale getiriyor. Cihaz ilk filtreyi yapıp sadece gerekeni gönderdiğinde gecikme, bant genişliği ve maliyet aynı anda düşüyor.
Cihazda öğrenme. Bugün çoğu sistem yalnızca çıkarımı cihazda yapıyor, eğitim hâlâ bulutta. Kullanıcının alışkanlıklarına cihazın kendisinde uyum sağlayan modeller ve federe öğrenme bir sonraki büyük adım gibi duruyor; ama bellek ve enerji kısıtları düşünüldüğünde bu, çıkarımdan çok daha zor bir problem.
Yeşil yapay zeka. Verimli modeller ve düşük güçlü hızlandırıcılar artık yalnızca pil ömrü için değil, enerji tüketimi ve karbon ayak izi için de konuşuluyor. Her sorgunun bir veri merkezine gitmediği bir mimari, bu tartışmada da elini güçlendiriyor.
Etik ve adalet. Küçük modellerde önyargı ve açıklanabilirlik ayrı bir araştırma başlığına dönüştü. Model cihazda çalıştığında denetlemek de zorlaşıyor; bu yüzden şeffaflık ve test süreçlerinin en baştan tasarlanması gerekiyor.
Yapay zeka servisten yazılıma dönüşürken
SQLite'ı kimse bir "servis" olarak düşünmez. Neredeyse her telefonda ve tarayıcıda çalışıyor ama kimse onun için API anahtarı almıyor, fatura ödemiyor ya da verisinin nereye gittiğini merak etmiyor. Uygulamanın içinde gelen sıradan bir bileşen, o kadar.
Yapay zeka modellerinin de bu konuma gelmesi bana hiç uzak görünmüyor ve akademi de aynı yöne bakıyor. MobiCom 2024'te yayımlanan "Mobile Foundation Model as Firmware" çalışması, temel modeli her uygulamanın ayrı ayrı paketlediği bir şey yerine cihaza gömülü bir altyapı katmanı olarak düşünmeyi öneriyor. Geliştirici açısından hesap da değişiyor: çıkarım maliyeti kullanıcının cihazına geçiyor, token başına kesilen bir fatura kalmıyor.
Merkeziyetsiz AI tartışmasının en somut karşılığı da bence bu: modelin ağırlıkları açık, çalıştığı donanım kullanıcının cebinde. Üretken modeller de yeterince güvenilir hale geldiğinde "uygulamamda yapay zeka var" demek, bugün "uygulamamda veritabanı var" demek kadar sıradan gelecek. O güne kadar yapılacak en akıllıca şey, küçük ve spesifik problemlerle başlayıp bu araçları şimdiden tanımak.
Sık sorulan sorular
On-device AI nedir?
Yapay zeka modelinin veriyi buluta göndermeden, çıkarımı doğrudan telefon, bilgisayar, araç veya IoT cihazı üzerinde yapmasıdır. Öne çıkan özellikleri düşük gecikme, kısıtlı kaynakla çalışabilmesi ve verinin yerelde kalmasıdır.
Edge AI ile on-device AI aynı şey mi?
Yakın ama aynı değil. Edge AI, işlemi veri kaynağına yakın her noktaya (kenar sunucular, ağ geçitleri, cihazlar) taşıyan daha geniş bir şemsiye; on-device AI ise işin doğrudan son kullanıcı cihazında yapıldığı durumu anlatıyor.
Bir yapay zeka modeli cihaza nasıl sığdırılır?
Genellikle birkaç teknik birlikte kullanılır: kuantizasyon, budama, bilgi damıtma ve verimli mimari tasarımı. Bunlara uygun bir çıkarım çatısı ve NPU gibi donanım hızlandırıcılar eşlik eder.
Telefonda büyük dil modeli çalışır mı?
Küçük dil modelleri çalışıyor. 1 ile 3 milyar parametre aralığındaki modeller kuantizasyonla güncel telefonlarda çalıştırılabiliyor; ancak hız, pil tüketimi ve cevap kalitesi cihaza göre ciddi biçimde değişiyor.
On-device AI gizliliği garanti eder mi?
Tek başına etmez. Verinin cihazdan çıkmaması riski azaltır, ama cihaz güvenliği, modelin korunması ve uygulamanın veriyi nasıl sakladığı ayrıca ele alınmalıdır.
Kaynaklar ve ileri okuma
- Wang, X. ve ark. (2025). Empowering Edge Intelligence: A Comprehensive Survey on On-Device AI Models. ACM Computing Surveys. arXiv:2503.06027
- Luo, C. ve ark. (2020). Comparison and Benchmarking of AI Models and Frameworks on Mobile Devices. arXiv:2005.05085
- Yuan, J. ve ark. (2024). Mobile Foundation Model as Firmware. MobiCom 2024.
- Google DeepMind (6 Ekim 2026). EmbeddingGemma 2 duyurusu ve model kartı.