Netflix schlägt dir eine Serie vor, dein Postfach fängt Spam ab, ein Auto erkennt ein Stoppschild: In allen drei Fällen ist Machine Learning am Werk. Der Name klingt nach einer Maschine, die so lernt wie wir. Das tut sie nicht, und wenn man versteht, warum, kann man viel besser einschätzen, was solche Systeme können und was nicht.
Maschinen lernen nicht, sie passen an
Wenn Menschen lernen, nehmen sie Informationen auf, verknüpfen sie mit ihrem Vorwissen und wenden sie auf Situationen an, die sie noch nie erlebt haben. Ein Machine-Learning-Modell macht etwas viel Engeres. Man zeigt ihm sehr viele Beispiele, und es sucht eine mathematische Funktion, die die Eingaben möglichst oft in die richtigen Ausgaben übersetzt.
Andriy Burkov bringt das in The Hundred-Page Machine Learning Book auf den Punkt. Ein trainiertes Modell ist eine Funktion, die bei Eingaben gut funktioniert, die den Trainingsdaten ähneln. Entfernt man sich weit genug davon, kann das Ergebnis völlig falsch sein, ganz ohne Vorwarnung. Ein Modell, das handgeschriebene Ziffern lesen soll, „liest“ einen handgeschriebenen Buchstaben seelenruhig als irgendeine Ziffer, denn Ziffern sind das Einzige, von dem es weiß, dass es existiert.
Nutzlos ist es deshalb nicht. Es heißt nur, dass das Modell genau so gut ist wie die Daten, an die es angepasst wurde, und dass es nicht merkt, wenn es diese Daten verlässt.
Die drei Hauptarten des Machine Learning
1. Überwachtes Lernen
Stell dir einen Schüler vor, der mit einem Lösungsheft übt. Das Modell bekommt Beispiele zusammen mit der richtigen Antwort: Tausende Fotos mit der Beschriftung „Katze“ oder „keine Katze“, E-Mails mit „Spam“ oder „kein Spam“. Es passt sich so lange an, bis seine Antworten möglichst gut zu den Beschriftungen passen, und wendet dieselbe Funktion dann auf neue Beispiele an. Der Großteil des Machine Learning in Alltagsprodukten ist überwacht, vom Spamfilter über die medizinische Bildanalyse bis zur Spracherkennung.
2. Unüberwachtes Lernen
Jetzt stell dir einen Schüler vor, der einen Stapel Bücher ohne jede Anleitung bekommt und sie selbst in Gruppen sortieren soll. Unüberwachtes Lernen bekommt Rohdaten ohne Beschriftung und sucht darin nach Strukturen. Ein typischer Einsatz ist die Kundensegmentierung: Ein Händler teilt seine Kunden nach ihrem Kaufverhalten in Gruppen ein, ohne vorher zu wissen, welche Gruppen dabei herauskommen.
3. Bestärkendes Lernen
Das ist Lernen durch Versuch und Irrtum. Das Modell handelt in einer Umgebung und bekommt je nach Ergebnis eine Belohnung oder eine Strafe. Ein Spielprogramm macht Züge, gewinnt oder verliert irgendwann und verschiebt seine Strategie nach und nach hin zu den Zügen, die zum Sieg führen. Bestärkendes Lernen steckt hinter bekannten Spielsystemen wie AlphaGo und wird in der Robotik und beim Feintuning großer Sprachmodelle eingesetzt.
Wie ein Modell aus Daten lernt: ein Spamfilter
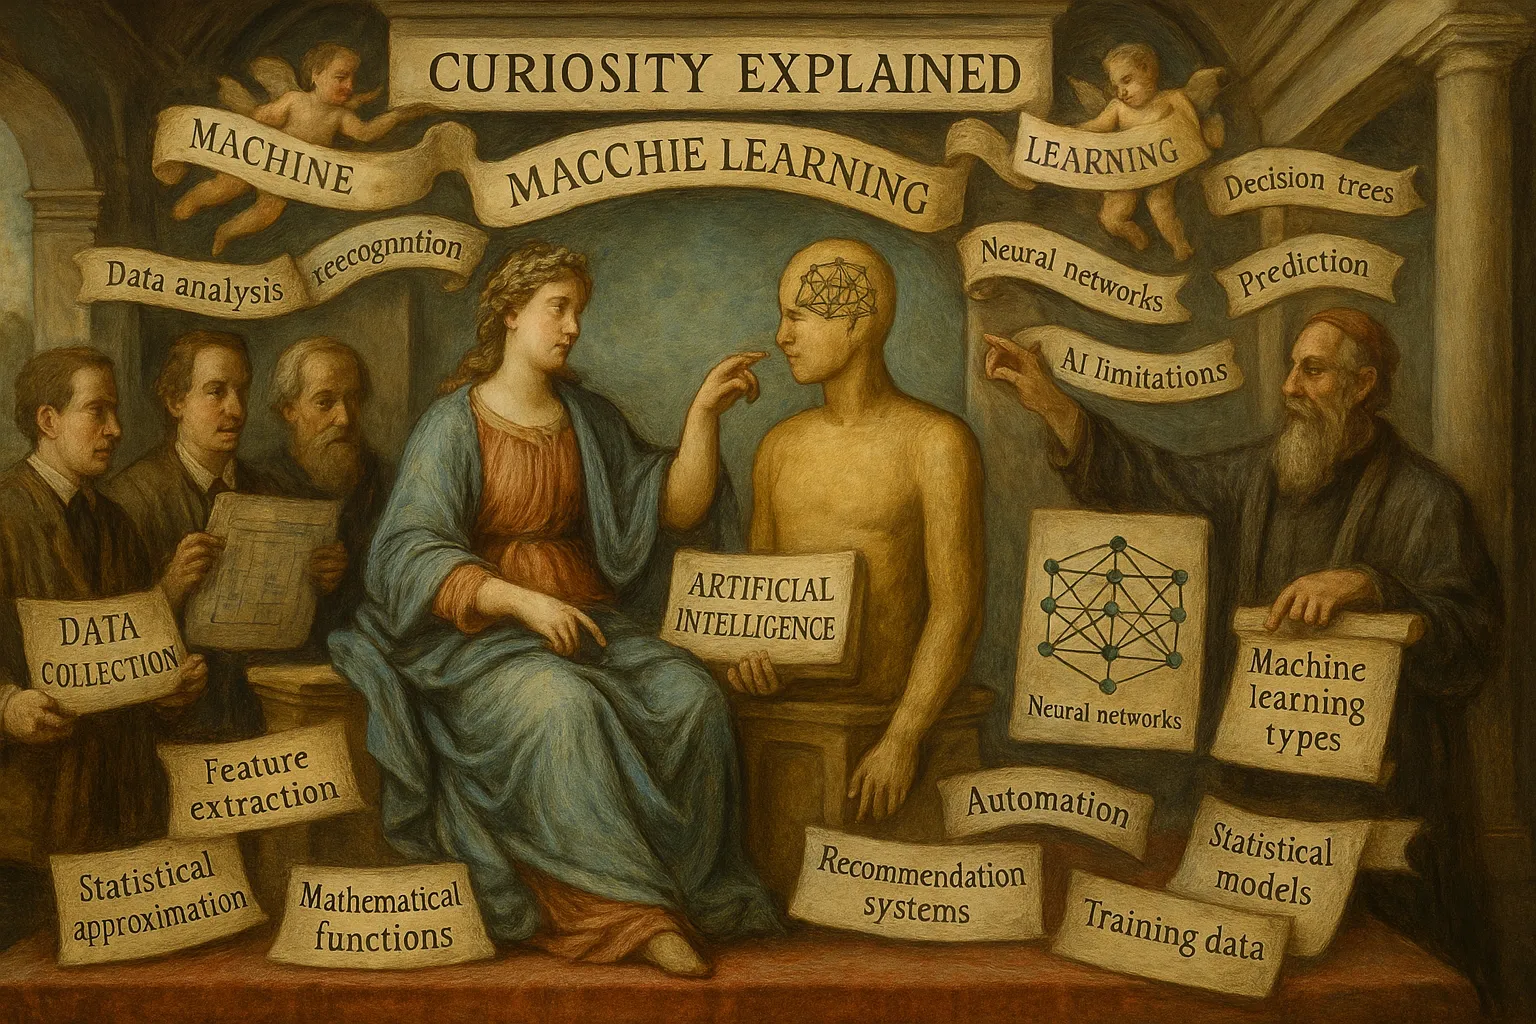
- Daten sammeln. Tausende E-Mails zusammentragen, jede als Spam oder kein Spam markiert.
- Merkmale extrahieren. Jede E-Mail in messbare Signale übersetzen: welche Wörter vorkommen, wie lang sie ist, wie viele Links sie enthält, wer sie geschickt hat.
- Trainieren. Ein Algorithmus wie ein Entscheidungsbaum oder ein neuronales Netz sucht die Kombination von Merkmalen, die Spam am besten vom Rest trennt.
- Vorhersagen. Trifft eine neue E-Mail ein, wendet das Modell diese Funktion an und fällt sein Urteil.
- Neu trainieren. Spammer ändern ihre Taktik, also wird das Modell regelmäßig mit frischen, markierten E-Mails nachtrainiert.
Das ähnelt ein wenig einem Schüler, der so viele Probeklausuren geschrieben hat, dass er die Aufgabentypen wiedererkennt. Der Unterschied: Der Schüler versteht den Stoff irgendwann. Das Modell nie. Es folgt nur dem Weg, den die Optimierung gefunden hat.
Warum das Wort „Lernen“ in die Irre führt
Arthur Samuel, ein KI-Pionier bei IBM, gilt als derjenige, der den Begriff Machine Learning 1959 geprägt hat, bei seiner Arbeit an einem Programm, das Dame spielte. Burkov meint, der Begriff sei schon immer eher ein griffiges Etikett gewesen als eine wörtliche Beschreibung. „Künstliche Intelligenz“ bedeutet keine Intelligenz im menschlichen Sinn, und „maschinelles Lernen“ bedeutet auch kein Lernen im menschlichen Sinn. „Automatisierte Mustererkennung“ oder „statistische Näherung“ wären treffender, wenn auch deutlich weniger aufregend.
Menschen und Modelle im Vergleich
- Menschen verstehen Zusammenhänge, machen gedankliche Sprünge und kommen mit völlig neuen Situationen zurecht.
- Modelle finden Muster und optimieren ihre Ausgabe, verstehen aber nichts über das hinaus, was in ihren Trainingsdaten steckte.
Die Folgen sind ganz praktisch. Ein Fahrsystem, das überwiegend auf sonnigen Straßen trainiert wurde, kann bei Schnee, den es nie gesehen hat, Probleme bekommen. Modelle für medizinische Bildgebung, die mit Aufnahmen aus einem Krankenhaus trainiert wurden, schnitten bei Aufnahmen aus einem anderen Krankenhaus wiederholt schlechter ab, unter anderem weil sie Unterschiede zwischen den Geräten gelernt hatten statt Merkmale der Krankheit.
Und große Sprachmodelle?
Chatbots auf Basis großer Sprachmodelle wirken wie die Ausnahme, weil sie über fast alles flüssig schreiben. Darunter steckt aber dieselbe Idee in riesigem Maßstab: ein Modell, das darauf trainiert wurde, das nächste Textstück vorherzusagen, angepasst an einen großen Teil des geschriebenen Internets. Dieser Maßstab macht sie viel allgemeiner als einen Spamfilter. Trotzdem scheitern sie so, wie jede angepasste Funktion scheitert. Fällt eine Frage aus dem Bereich, den ihre Daten abgedeckt haben, sagen sie nicht „Ich weiß es nicht“, sondern liefern etwas Plausibles, das falsch sein kann.
Mächtig, aber ein Werkzeug
Machine Learning hat Medizin, Finanzwesen, Logistik und Unterhaltung verändert und wird das weiter tun. Aber es bleibt ein Werkzeug. Ein Taschenrechner multipliziert schneller als jeder Mensch, ohne zu wissen, was die Zahlen bedeuten, und ein Modell erkennt Muster, ohne zu wissen, was sie bedeuten.
Wer das im Kopf behält, hat realistische Erwartungen. Gute Ergebnisse entstehen aus sorgfältig ausgewählten Daten, vernünftigen Algorithmen und Menschen, die die Ausgabe prüfen, nicht aus der Hoffnung, ein Modell werde das Problem schon verstehen, wenn es nur genug Daten gesehen hat.
Wenn also das nächste Mal eine Empfehlung deine Gedanken zu lesen scheint: Sie hat nichts über dich gelernt, jedenfalls nicht im menschlichen Sinn. Sie hat eine Funktion gefunden, die zu Menschen passt, deren Verhalten deinem ähnelt.
Angeregt durch Ideen aus Andriy Burkovs The Hundred-Page Machine Learning Book.